Dalla manutenzione reattiva alla predittiva: quando dati e IA aiutano davvero
Come scegliere un primo progetto di manutenzione su condizione o predittiva in un resort, distinguendo monitoraggio, diagnosi e IA e misurando il valore delle segnalazioni.
In questo approfondimento
- Il problema viene prima dell'algoritmo
- Un dato reale sul valore dell'analisi degli impianti
- Distinguere quattro decisioni diverse
- Scegliere un primo caso con un esito osservabile
- Mettere ordine nei dati prima di addestrare un modello
- Valutare gli avvisi con il lavoro reale
- Il ruolo dell'IA e quello delle persone
- Collegare il segnale al ripristino
Il problema viene prima dell'algoritmo
Una pompa si guasta e la squadra interviene: è una risposta reattiva. La stessa pompa viene controllata periodicamente: esiste una prevenzione organizzata. Una misura segnala un degrado e consente di programmare un intervento: il lavoro cambia ancora. Nessuno di questi passaggi richiede, da solo, di dichiarare che l'impianto utilizzi intelligenza artificiale.
Per un resort la domanda iniziale dovrebbe riguardare il servizio: quale guasto vogliamo riconoscere prima, quale segnale può anticiparlo e quanto tempo ci serve per intervenire? Se il ricambio richiede settimane e il segnale compare poche ore prima del guasto, l'analisi può essere interessante senza risolvere il problema operativo. Se nessuno riceve e valuta gli avvisi, anche un modello accurato resta inutilizzato.
Un dato reale sul valore dell'analisi degli impianti
La Smart Energy Analytics Campaign, condotta negli Stati Uniti tra il 2016 e il 2020, ha coinvolto 104 organizzazioni e 6.500 edifici. Il rapporto del Lawrence Berkeley National Laboratory riporta risparmi energetici annuali mediani del 3% per gli Energy Information Systems e del 9% per la rilevazione e diagnosi dei guasti, o FDD.[1]
Sono risultati di un programma su edifici commerciali, non una prova che qualsiasi resort otterrà le stesse percentuali. Riguardano strumenti e processi di gestione energetica: non equivalgono a un risparmio garantito da un CMMS, né dimostrano che l'IA generativa sappia prevedere un guasto. Indicano però che organizzare i dati e usarli per correggere il funzionamento può produrre risultati misurabili.
Distinguere quattro decisioni diverse
| Approccio | Che cosa fa partire l'intervento | Esempio nel resort |
|---|---|---|
| Correttivo | Guasto o anomalia già manifesti | Ripristino di un ventilatore fermo |
| Preventivo programmato | Scadenza, uso o programma definito | Controllo pianificato secondo condizioni e istruzioni applicabili |
| Su condizione | Stato misurato e interpretato | Verifica di un componente quando un parametro indica degrado |
| Predittivo | Stima dell'evoluzione futura | Programmazione sulla base di una previsione validata del degrado |
La tabella usa una distinzione operativa utile per scegliere il progetto; nella documentazione tecnica alcuni termini possono sovrapporsi. Il Department of Energy descrive sia diagnosi automatizzate basate su regole sia applicazioni che usano dati di impianto per formulare raccomandazioni manutentive.[2] Un allarme di soglia non è, da solo, una previsione; una diagnosi automatica può funzionare senza apprendimento automatico.
Non tutti i componenti richiedono il livello più sofisticato. Per un elemento economico, accessibile e con guasto senza conseguenze rilevanti può essere ragionevole una strategia semplice. Per un servizio essenziale, la combinazione di controlli, ridondanza, ricambi e competenze può pesare più della complessità del modello.
Scegliere un primo caso con un esito osservabile
Un buon progetto pilota parte da una famiglia limitata di apparecchiature e da un fenomeno definito. Per esempio, si può voler riconoscere un funzionamento incoerente di un circuito di climatizzazione quando le condizioni d'uso sono comparabili. Occorre stabilire quali parametri servono, quale controllo in campo confermerà l'anomalia e quale azione sarà possibile.
La scheda del progetto dovrebbe contenere: problema, conseguenza sul servizio, segnali disponibili, qualità minima richiesta, responsabile della valutazione e criterio di successo. Conviene aggiungere anche un criterio di arresto: se gli avvisi non sono verificabili o producono più lavoro inutile che beneficio, il progetto va corretto prima di estenderlo.
Il primo risultato cercato può essere modesto e utile: individuare un'anomalia ricorrente prima della segnalazione dell'ospite. Non serve promettere una data esatta di rottura quando i dati disponibili consentono soltanto di riconoscere un comportamento insolito.
Mettere ordine nei dati prima di addestrare un modello
Il codice dell'apparecchiatura deve essere stabile e riconoscibile nei sistemi coinvolti. Orari, unità di misura e modalità di acquisizione devono essere coerenti. Un valore mancante non è zero; una misura ricostruita non equivale a una misura letta; un sensore sostituito può introdurre una discontinuità che il modello interpreta erroneamente come guasto.
Lo storico degli interventi deve distinguere almeno sintomo segnalato, causa verificata, azione ed esito. Se ogni intervento viene chiuso con “riparato”, il sistema non dispone di un riscontro sufficiente per imparare quali segnali fossero significativi. Anche i periodi senza guasti sono informativi: occorre sapere quando l'impianto ha lavorato normalmente e in quali condizioni.
Prima di valutare prestazioni avanzate conviene verificare la completezza delle registrazioni e la disponibilità effettiva dei dati. Un progetto che copre soltanto la bassa stagione non dimostra automaticamente il proprio comportamento nei giorni di piena occupazione. La qualità del modello dipende anche dalla rappresentatività delle condizioni osservate.
Valutare gli avvisi con il lavoro reale
Esempio illustrativo — ipotesi, non dati osservati. In un periodo pilota vengono prodotti 20 avvisi riferiti a eventi distinti. I tecnici ne confermano 12 come anomalie pertinenti; 8 risultano falsi allarmi. Tra gli avvisi generati, la quota confermata è quindi 12/20 = 60%. Questo indicatore non dice quanti problemi siano sfuggiti al sistema.
Per misurare anche i mancati rilevamenti serve un riscontro indipendente. Se nel periodo fossero state accertate complessivamente 15 anomalie del tipo cercato e 12 fossero state intercettate, la quota riconosciuta sarebbe 12/15 = 80%. Queste due misure rispondono a domande diverse: quanta fiducia assegnare a un avviso e quanti eventi si riescono a riconoscere.
Vanno poi considerati il tempo di anticipo utile, le ore spese per controlli inutili e la possibilità concreta di intervenire. Per verificare una previsione occorre provarla su dati successivi a quelli utilizzati per costruirla, evitando di valutare il modello su informazioni che aveva già visto. Dopo modifiche all'impianto o alle modalità d'uso, la verifica va ripetuta.
Il ruolo dell'IA e quello delle persone
L'IA può contribuire a ordinare segnalazioni, individuare ricorrenze o preparare un riepilogo dello storico. Quando formula una spiegazione tecnica, il risultato deve essere confrontabile con registrazioni, misure e documenti pertinenti. Una risposta plausibile non costituisce la prova della causa di un guasto.
Il NIST AI Risk Management Framework 1.0, pubblicato nel 2023, propone un quadro volontario per gestire i rischi lungo la vita dei sistemi di IA, con attenzione a validità, affidabilità, trasparenza e supervisione.[3] Nel resort questo orientamento si traduce in regole pratiche: identificare chi valuta l'avviso, registrare perché viene accettato o scartato e mantenere una procedura utilizzabile anche quando l'analisi automatizzata non è disponibile.
In una piattaforma usata da organizzazioni diverse, la separazione dei dati deve riguardare l'intero processo: accessi, documenti recuperati, elaborazioni e risultati. I dati di un resort non dovrebbero comparire nelle risposte destinate a un altro. Questi sono requisiti da verificare nell'architettura e nell'uso del servizio, non capacità attribuibili a un prodotto soltanto perché viene definito “intelligente”.
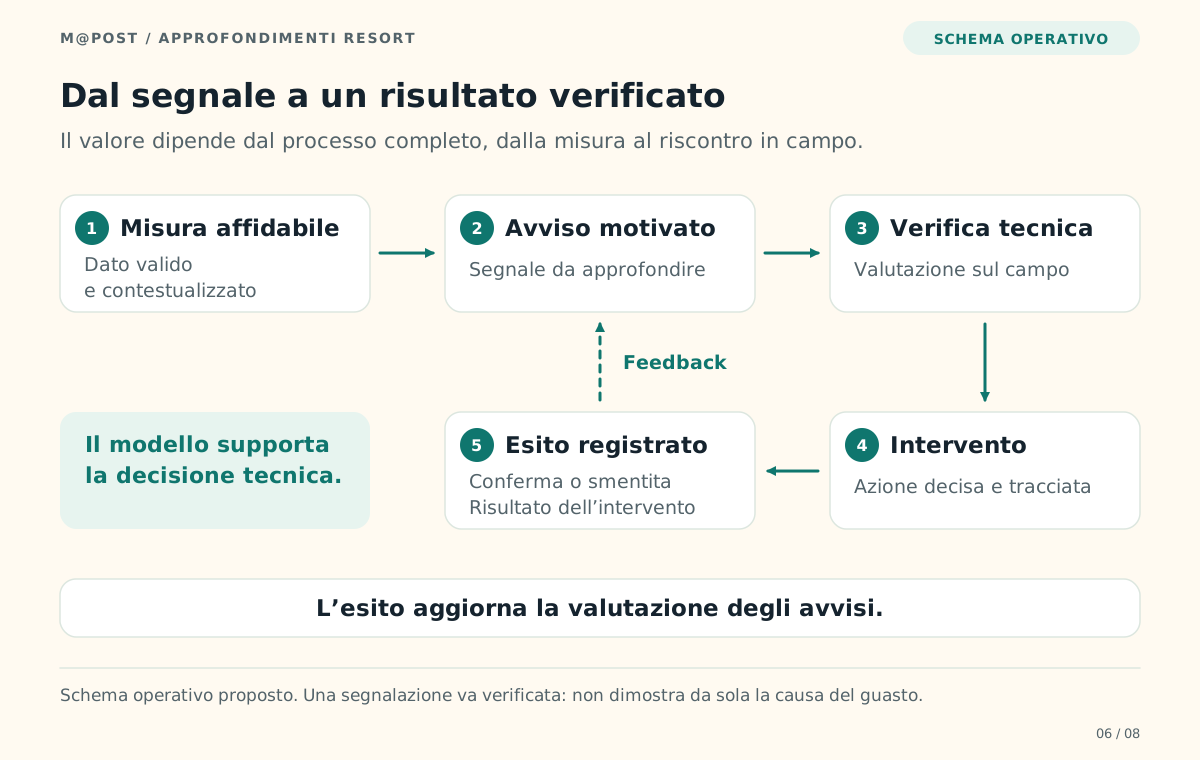
Descrizione testuale della figura
Cinque passaggi collegano misura, avviso, verifica tecnica, intervento ed esito; un ritorno aggiorna la valutazione degli avvisi.
Collegare il segnale al ripristino
Il percorso utile si chiude quando un avviso diventa una decisione, un intervento e un esito verificato. Il sistema di monitoraggio descrive il comportamento dell'impianto; il processo manutentivo assegna lavoro, tempi e responsabilità. Il CMMS può fare da registro operativo secondo le integrazioni e le funzioni effettivamente disponibili.
Per M@Post il metodo da rendere riconoscibile è quindi progressivo: partire da dati affidabili, scegliere un problema circoscritto, verificare gli avvisi e misurare il servizio recuperato. La maturità si vede quando la squadra comprende perché interviene e può dimostrare il risultato. Una previsione ha valore quando arriva in tempo per cambiare una decisione.
Fonti e riferimenti
- Lawrence Berkeley National Laboratory — Proving the Business Case for Building AnalyticsPubblicazione: 2020-10. Consultato il 21 novembre 2026.Ambito: Smart Energy Analytics Campaign 2016–2020
- US Department of Energy — Federal Energy Management Program — Energy Management Information System CapabilitiesConsultato il 21 novembre 2026.Ambito: Risorsa tecnica corrente consultata il 21 novembre 2026
- National Institute of Standards and Technology — Artificial Intelligence Risk Management Framework (AI RMF 1.0)Pubblicazione: 2023-01. Consultato il 21 novembre 2026.Ambito: Framework metodologico, versione 1.0