Da manutenção reativa à preditiva: quando os dados e a IA ajudam
Como escolher um primeiro projeto de manutenção baseada na condição ou preditiva para um resort, distinguir monitoramento, diagnóstico e IA e medir o valor dos alertas.
Neste guia
- O problema vem antes do algoritmo
- Evidências reais do valor da análise de dados dos edifícios
- Distinguir quatro decisões diferentes
- Escolher um primeiro caso de uso com resultado observável
- Organizar os dados antes de treinar um modelo
- Avaliar os alertas em relação ao trabalho real
- O papel da IA e o papel das pessoas
- Conectar o sinal ao restabelecimento do serviço
O problema vem antes do algoritmo
Uma bomba falha e a equipe atende à ocorrência: isso é manutenção reativa. A mesma bomba passa por inspeções periódicas: existe uma abordagem preventiva organizada. Uma medição identifica uma deterioração e permite programar uma intervenção: o trabalho muda novamente. Nenhuma dessas etapas, isoladamente, exige afirmar que o sistema usa inteligência artificial.
Para um resort, a primeira pergunta deve tratar do serviço: qual falha queremos identificar mais cedo, qual sinal poderia antecipá-la e de quanto tempo precisamos para agir? Se uma peça de reposição leva semanas para chegar e o sinal aparece apenas horas antes da falha, a análise pode ser interessante sem resolver o problema operacional. Se ninguém recebe e avalia os alertas, até um modelo preciso ficará sem uso.
Evidências reais do valor da análise de dados dos edifícios
A Smart Energy Analytics Campaign, realizada nos Estados Unidos entre 2016 e 2020, envolveu 104 organizações e 6.500 edifícios. O relatório do Lawrence Berkeley National Laboratory registra uma mediana de economia anual de energia de 3% para sistemas de informação energética, ou EIS, e de 9% para sistemas de detecção e diagnóstico de falhas, ou FDD.[1]
São resultados de um programa que abrange edifícios comerciais, e não uma demonstração de que qualquer resort alcançará os mesmos percentuais. Eles se referem a ferramentas e processos de gestão de energia: não representam economias garantidas por um CMMS, nem demonstram que a IA generativa pode prever uma falha. Indicam, porém, que organizar dados e usá-los para corrigir o funcionamento das instalações pode produzir resultados mensuráveis.
Distinguir quatro decisões diferentes
| Abordagem | O que desencadeia a intervenção | Exemplo no resort |
|---|---|---|
| Corretiva | Uma falha ou avaria que já ocorreu | Restabelecer o funcionamento de um ventilador que parou |
| Preventiva programada | Um vencimento, o uso ou um programa definido | Uma inspeção planejada conforme as condições e instruções aplicáveis |
| Baseada na condição | Uma condição medida e interpretada | Verificar um componente quando um parâmetro indica deterioração |
| Preditiva | Uma estimativa do comportamento futuro | Programar um trabalho com base em uma previsão validada de deterioração |
A tabela estabelece uma distinção operacional que ajuda a selecionar projetos; alguns termos podem se sobrepor na documentação técnica. O US Department of Energy descreve tanto diagnósticos automatizados baseados em regras quanto aplicações que usam dados das instalações para gerar recomendações de manutenção.[2] Um alarme de limite, por si só, não é uma previsão; o diagnóstico automatizado pode funcionar sem aprendizado de máquina.
Nem todo componente precisa da abordagem mais sofisticada. Uma estratégia simples pode ser adequada para um item barato e acessível cuja falha não tenha consequências significativas. Para um serviço essencial, a combinação de inspeções, redundância, peças de reposição e conhecimento técnico pode importar mais do que a complexidade do modelo.
Escolher um primeiro caso de uso com resultado observável
Um bom projeto-piloto começa com uma família limitada de equipamentos e um fenômeno definido. Por exemplo, o objetivo pode ser identificar um funcionamento inconsistente em um circuito de aquecimento ou resfriamento em condições operacionais comparáveis. O projeto precisa estabelecer quais parâmetros são necessários, qual verificação no local confirmará a anomalia e que medida poderá ser tomada.
O registro do projeto deve incluir o problema, seu impacto no serviço, os sinais disponíveis, a qualidade mínima exigida, o responsável pela avaliação e o critério de sucesso. Também é útil acrescentar um critério de interrupção: se os alertas não puderem ser verificados ou gerarem mais trabalho desnecessário do que benefício, o projeto deverá ser corrigido antes de ser ampliado.
O primeiro objetivo pode ser modesto e útil: identificar uma anomalia recorrente antes que um hóspede a comunique. Não é necessário prometer uma data exata para a falha quando os dados disponíveis permitem apenas reconhecer um comportamento incomum.
Organizar os dados antes de treinar um modelo
O identificador do equipamento deve permanecer estável e ser reconhecível nos sistemas envolvidos. Os registros de data e hora, as unidades de medida e os métodos de coleta devem ser consistentes. Um valor ausente não é zero; uma medição reconstruída não equivale a uma leitura; e a troca de um sensor pode introduzir uma descontinuidade que o modelo interprete, incorretamente, como falha.
O histórico de manutenção deve distinguir, no mínimo, o sintoma relatado, a causa verificada, a ação realizada e o resultado. Se toda ordem de serviço for encerrada com “reparado”, o sistema não terá retorno suficiente para aprender quais sinais foram relevantes. Os períodos sem falhas também trazem informações: é necessário saber quando o sistema funcionou normalmente e em quais condições.
Antes de avaliar um desempenho avançado, verifique a completude dos registros e se os dados estão realmente disponíveis. Um projeto que abrange apenas a baixa temporada não demonstra automaticamente como funcionará nos dias de ocupação plena. A qualidade do modelo também depende de quão representativas são as condições observadas.
Avaliar os alertas em relação ao trabalho real
Exemplo ilustrativo — hipóteses, não dados observados. Durante um período-piloto, são gerados 20 alertas para eventos distintos. Os técnicos confirmam 12 como anomalias relevantes; 8 são falsos alarmes. Portanto, a proporção de alertas gerados que foi confirmada é 12/20 = 60%. Esse indicador não mostra quantos problemas o sistema deixou de detectar.
Medir as falhas de detecção também exige uma verificação independente. Se um total de 15 anomalias do tipo procurado tivesse sido confirmado no período e 12 tivessem sido detectadas, a proporção reconhecida seria 12/15 = 80%. Essas duas medidas respondem a perguntas diferentes: quanta confiança depositar em um alerta e quantos eventos o sistema consegue reconhecer.
A avaliação também deve considerar a antecedência útil do aviso, as horas gastas em verificações desnecessárias e a viabilidade de intervir. Uma previsão deve ser testada com dados de um período posterior ao dos dados usados para construí-la, evitando avaliá-la com informações que o modelo já viu. A verificação deve se repetir após mudanças nas instalações ou em seu padrão de operação.
O papel da IA e o papel das pessoas
A IA pode ajudar a organizar chamados, identificar padrões recorrentes ou preparar um resumo do histórico de manutenção. Quando oferece uma explicação técnica, essa explicação precisa poder ser verificada com registros, medições e documentos pertinentes. Uma resposta plausível não é evidência da causa de uma falha.
O NIST AI Risk Management Framework 1.0, publicado em 2023, oferece uma estrutura voluntária para gerir riscos ao longo da vida dos sistemas de IA, com atenção à validade, confiabilidade, transparência e supervisão.[3] Em um resort, essa abordagem se traduz em regras práticas: identificar quem avalia um alerta, registrar por que ele foi aceito ou rejeitado e manter um procedimento utilizável nos momentos em que a análise automatizada estiver indisponível.
Em uma plataforma utilizada por diferentes organizações, a separação dos dados deve abranger todo o processo: acesso, documentos recuperados, processamento e resultados. Os dados de um resort não devem aparecer nas respostas destinadas a outro. Esses são requisitos a verificar na arquitetura e na operação do serviço, e não capacidades que se possam atribuir a um produto simplesmente porque ele é descrito como “inteligente”.
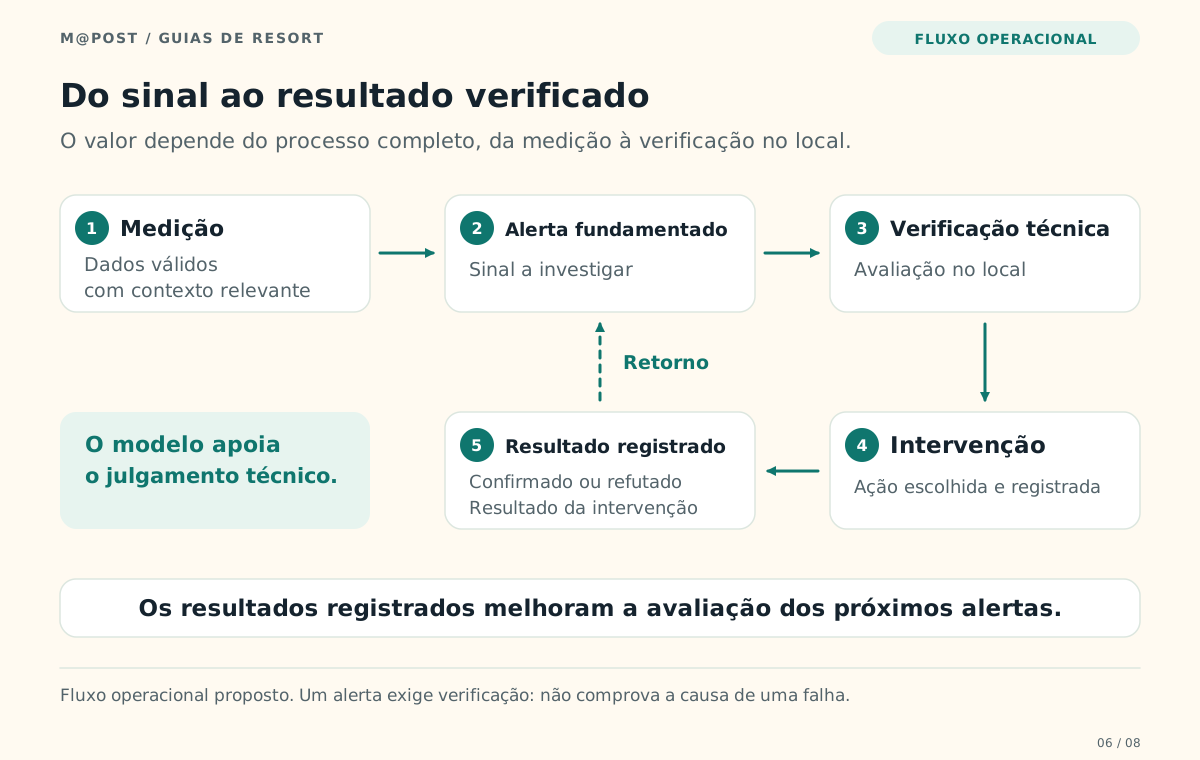
Descrição textual desta figura
Cinco etapas conectam medição, alerta, verificação técnica, intervenção e resultado; um ciclo de retorno orienta a avaliação dos alertas.
Conectar o sinal ao restabelecimento do serviço
O processo útil se completa quando um alerta se transforma em uma decisão, uma intervenção e um resultado verificado. O sistema de monitoramento descreve o comportamento do equipamento; o processo de manutenção atribui tarefas, prazos e responsabilidades. O CMMS pode funcionar como registro operacional, de acordo com as integrações e funções efetivamente disponíveis.
Para o M@Post, a abordagem a deixar clara é, portanto, gradual: começar com dados confiáveis, escolher um problema bem delimitado, verificar os alertas e medir o serviço restabelecido. A maturidade aparece quando a equipe entende por que está intervindo e consegue demonstrar o resultado. Uma previsão tem valor quando chega a tempo de mudar uma decisão.
Fontes e referências
- Lawrence Berkeley National Laboratory — Proving the Business Case for Building AnalyticsPublicado: 2020-10. Fontes verificadas em 21 de novembro de 2026.Período e alcance dos dados: Smart Energy Analytics Campaign 2016–2020
Como esta fonte é utilizada
104 organizações e 6.500 edifícios; mediana de economia anual de energia de 3% para EIS e 9% para FDD.
Valores verificados no resumo oficial. Campanha que abrange edifícios comerciais; não permite extrapolação garantida para resorts ou para um CMMS.
- US Department of Energy — Federal Energy Management Program — Energy Management Information System CapabilitiesFontes verificadas em 21 de novembro de 2026.Período e alcance dos dados: Recurso técnico vigente consultado em 21 de novembro de 2026
Como esta fonte é utilizada
Diagnósticos automatizados, incluindo métodos baseados em regras; recomendações baseadas na condição ou preditivas e conexão com o processo de manutenção.
Seções Automated Fault Detection and Diagnostics e Operations and Maintenance Optimization. As distinções da tabela são uma síntese operacional editorial.
- National Institute of Standards and Technology — Artificial Intelligence Risk Management Framework (AI RMF 1.0)Publicado: 2023-01. Fontes verificadas em 21 de novembro de 2026.Período e alcance dos dados: Estrutura metodológica, versão 1.0
Como esta fonte é utilizada
Estrutura voluntária para a gestão dos riscos da IA, validade, confiabilidade, transparência e gestão de papéis ao longo do ciclo de vida.
Documento oficial NIST AI 100-1. O site do NIST informa que uma revisão está em andamento; o artigo identifica explicitamente a versão 1.0.