Von reaktiver zu vorausschauender Instandhaltung: Wann Daten und KI helfen
Ein erstes Projekt zur zustandsorientierten oder vorausschauenden Instandhaltung im Resort auswählen, Überwachung, Diagnose und KI unterscheiden und den Nutzen von Warnungen messen.
In diesem Ratgeber
- Das Problem kommt vor dem Algorithmus
- Reale Belege für den Nutzen von Gebäudeanalysen
- Vier unterschiedliche Entscheidungen auseinanderhalten
- Einen ersten Anwendungsfall mit beobachtbarem Ergebnis wählen
- Daten vor dem Modelltraining ordnen
- Warnungen an der tatsächlichen Arbeit bewerten
- Die Rolle der KI und die Rolle des Menschen
- Das Signal mit der Wiederherstellung verbinden
Das Problem kommt vor dem Algorithmus
Eine Pumpe fällt aus, und das Team reagiert: Das ist reaktive Instandhaltung. Dieselbe Pumpe wird regelmäßig geprüft: Ein geordnetes vorbeugendes Vorgehen entsteht. Eine Messung erkennt eine Verschlechterung und ermöglicht die Planung eines Eingriffs: Die Arbeit verändert sich erneut. Keiner dieser Schritte erfordert für sich genommen die Aussage, das System nutze künstliche Intelligenz.
Für ein Resort sollte die erste Frage die Leistung betreffen: Welchen Ausfall wollen wir früher erkennen, welches Signal könnte ihn ankündigen und wie viel Zeit brauchen wir zum Handeln? Dauert die Ersatzteilbeschaffung Wochen, während das Signal erst Stunden vor dem Ausfall erscheint, kann die Analyse interessant sein, ohne das betriebliche Problem zu lösen. Nimmt niemand die Warnungen entgegen und bewertet sie, bleibt auch ein präzises Modell ungenutzt.
Reale Belege für den Nutzen von Gebäudeanalysen
An der US-amerikanischen Smart Energy Analytics Campaign zwischen 2016 und 2020 nahmen 104 Organisationen mit 6.500 Gebäuden teil. Der Bericht des Lawrence Berkeley National Laboratory nennt jährliche Energieeinsparungen im Median von 3 % für Energy Information Systems und 9 % für Fehlererkennung und -diagnose, kurz FDD.[1]
Dies sind Ergebnisse eines Programms für gewerblich genutzte Gebäude und kein Nachweis dafür, dass jedes Resort dieselben Prozentsätze erreicht. Sie betreffen Werkzeuge und Prozesse des Energiemanagements: Sie sind weder durch ein CMMS garantierte Einsparungen noch ein Beleg dafür, dass generative KI einen Ausfall vorhersagen kann. Sie zeigen jedoch, dass geordnete Daten und ihre Nutzung zur Korrektur des Anlagenbetriebs messbare Ergebnisse ermöglichen können.
Vier unterschiedliche Entscheidungen auseinanderhalten
| Ansatz | Was den Eingriff auslöst | Beispiel im Resort |
|---|---|---|
| Korrektiv | Ein bereits eingetretener Ausfall oder Fehler | Einen stehen gebliebenen Ventilator wieder in Betrieb nehmen |
| Geplant vorbeugend | Ein Termin, die Nutzung oder ein festgelegtes Programm | Eine geplante Prüfung entsprechend den geltenden Bedingungen und Anweisungen |
| Zustandsorientiert | Ein gemessener und bewerteter Zustand | Ein Bauteil prüfen, wenn ein Parameter auf Verschlechterung hinweist |
| Vorausschauend | Eine Einschätzung des künftigen Verhaltens | Arbeiten anhand einer validierten Verschlechterungsprognose planen |
Die Tabelle trifft eine betriebliche Unterscheidung zur Projektauswahl; in technischen Unterlagen können sich manche Begriffe überschneiden. Das US Department of Energy beschreibt sowohl regelbasierte automatisierte Diagnosen als auch Anwendungen, die aus Anlagendaten Instandhaltungsempfehlungen ableiten.[2] Ein Grenzwertalarm allein ist noch keine Vorhersage; automatisierte Diagnose kann ohne maschinelles Lernen funktionieren.
Nicht jedes Bauteil braucht den anspruchsvollsten Ansatz. Für ein preiswertes, zugängliches Teil ohne erhebliche Ausfallfolgen kann eine einfache Strategie angemessen sein. Bei einer unverzichtbaren Leistung kann die Kombination aus Inspektionen, Redundanz, Ersatzteilen und Fachwissen wichtiger sein als die Komplexität des Modells.
Einen ersten Anwendungsfall mit beobachtbarem Ergebnis wählen
Ein gutes Pilotprojekt beginnt mit einer begrenzten Anlagenfamilie und einem definierten Phänomen. Ziel könnte beispielsweise sein, unplausiblen Betrieb in einem Heiz- oder Kühlkreislauf unter vergleichbaren Bedingungen zu erkennen. Das Projekt muss festlegen, welche Parameter erforderlich sind, welche Vor-Ort-Prüfung die Auffälligkeit bestätigt und welche Maßnahme möglich ist.
Der Projektsteckbrief sollte Problem, Serviceauswirkung, verfügbare Signale, erforderliche Mindestqualität, Verantwortliche für die Bewertung und Erfolgskriterium enthalten. Zusätzlich ist ein Abbruchkriterium hilfreich: Lassen sich Warnungen nicht prüfen oder verursachen sie mehr unnötige Arbeit als Nutzen, ist das Projekt vor einer Ausweitung zu korrigieren.
Das erste Ziel darf bescheiden und nützlich sein: eine wiederkehrende Auffälligkeit erkennen, bevor ein Gast sie meldet. Ein genauer Ausfalltermin muss nicht versprochen werden, wenn die verfügbaren Daten lediglich die Erkennung ungewöhnlichen Verhaltens erlauben.
Daten vor dem Modelltraining ordnen
Die Anlagenkennung muss dauerhaft und in allen beteiligten Systemen wiedererkennbar sein. Zeitstempel, Maßeinheiten und Erfassungsverfahren müssen zusammenpassen. Ein fehlender Wert ist keine Null; eine rekonstruierte Messung ist nicht dasselbe wie ein Messwert; ein Sensortausch kann einen Sprung erzeugen, den das Modell fälschlich als Störung interpretiert.
Die Instandhaltungshistorie sollte mindestens gemeldetes Symptom, bestätigte Ursache, ausgeführte Maßnahme und Ergebnis unterscheiden. Wird jeder Auftrag mit „repariert“ abgeschlossen, fehlen dem System ausreichende Rückmeldungen, um aussagekräftige Signale zu erkennen. Auch störungsfreie Zeiten liefern Informationen: Es muss bekannt sein, wann die Anlage normal und unter welchen Bedingungen lief.
Vor der Bewertung anspruchsvoller Leistungskennzahlen sind Vollständigkeit der Aufzeichnungen und tatsächliche Datenverfügbarkeit zu prüfen. Ein Projekt, das nur die Nebensaison abdeckt, belegt nicht automatisch sein Verhalten bei Vollbelegung. Die Modellqualität hängt auch davon ab, wie repräsentativ die beobachteten Bedingungen sind.
Warnungen an der tatsächlichen Arbeit bewerten
Rechenbeispiel — Annahmen, keine beobachteten Daten. In einer Pilotphase entstehen 20 Warnungen zu unterschiedlichen Ereignissen. Die Techniker bestätigen 12 davon als relevante Auffälligkeiten; 8 sind Fehlalarme. Der bestätigte Anteil der ausgegebenen Warnungen beträgt somit 12/20 = 60 %. Diese Kennzahl zeigt nicht, wie viele Probleme das System übersehen hat.
Um übersehene Ereignisse zu messen, ist zusätzlich eine unabhängige Prüfung nötig. Wären im betrachteten Zeitraum insgesamt 15 Auffälligkeiten des gesuchten Typs bestätigt worden und hätte das System 12 erkannt, läge der erkannte Anteil bei 12/15 = 80 %. Die beiden Kennzahlen beantworten unterschiedliche Fragen: Wie viel Vertrauen verdient eine Warnung, und wie viele Ereignisse kann das System erkennen?
Die Bewertung sollte außerdem nutzbare Vorwarnzeit, Stunden für unnötige Kontrollen und die praktische Eingriffsmöglichkeit berücksichtigen. Eine Prognose muss mit Daten aus einem späteren Zeitraum als den zur Modellentwicklung verwendeten Daten geprüft werden. So wird vermieden, das Modell anhand bereits bekannter Informationen zu bewerten. Nach Änderungen an der Anlage oder ihrer Betriebsweise ist die Prüfung zu wiederholen.
Die Rolle der KI und die Rolle des Menschen
KI kann helfen, Meldungen zu ordnen, wiederkehrende Muster zu erkennen oder eine Zusammenfassung der Instandhaltungshistorie vorzubereiten. Liefert sie eine technische Erklärung, muss diese anhand relevanter Aufzeichnungen, Messungen und Unterlagen überprüfbar sein. Eine plausible Antwort ist kein Nachweis für die Ursache eines Ausfalls.
Das NIST AI Risk Management Framework 1.0, veröffentlicht 2023, bietet einen freiwilligen Rahmen für das Risikomanagement über den Lebenszyklus von KI-Systemen. Es berücksichtigt unter anderem Validität, Zuverlässigkeit, Transparenz und Aufsicht.[3] Im Resort wird daraus ein praktisches Regelwerk: festlegen, wer eine Warnung bewertet, dokumentieren, weshalb sie akzeptiert oder verworfen wird, und ein nutzbares Verfahren für Zeiten ohne automatisierte Analyse vorhalten.
Auf einer von verschiedenen Organisationen genutzten Plattform muss die Datentrennung den gesamten Prozess abdecken: Zugriff, abgerufene Dokumente, Verarbeitung und Ergebnisse. Daten eines Resorts dürfen nicht in Antworten für ein anderes erscheinen. Dies sind Anforderungen, die in Architektur und Betrieb des Dienstes zu prüfen sind. Sie dürfen einem Produkt nicht allein deshalb zugeschrieben werden, weil es als „intelligent“ bezeichnet wird.
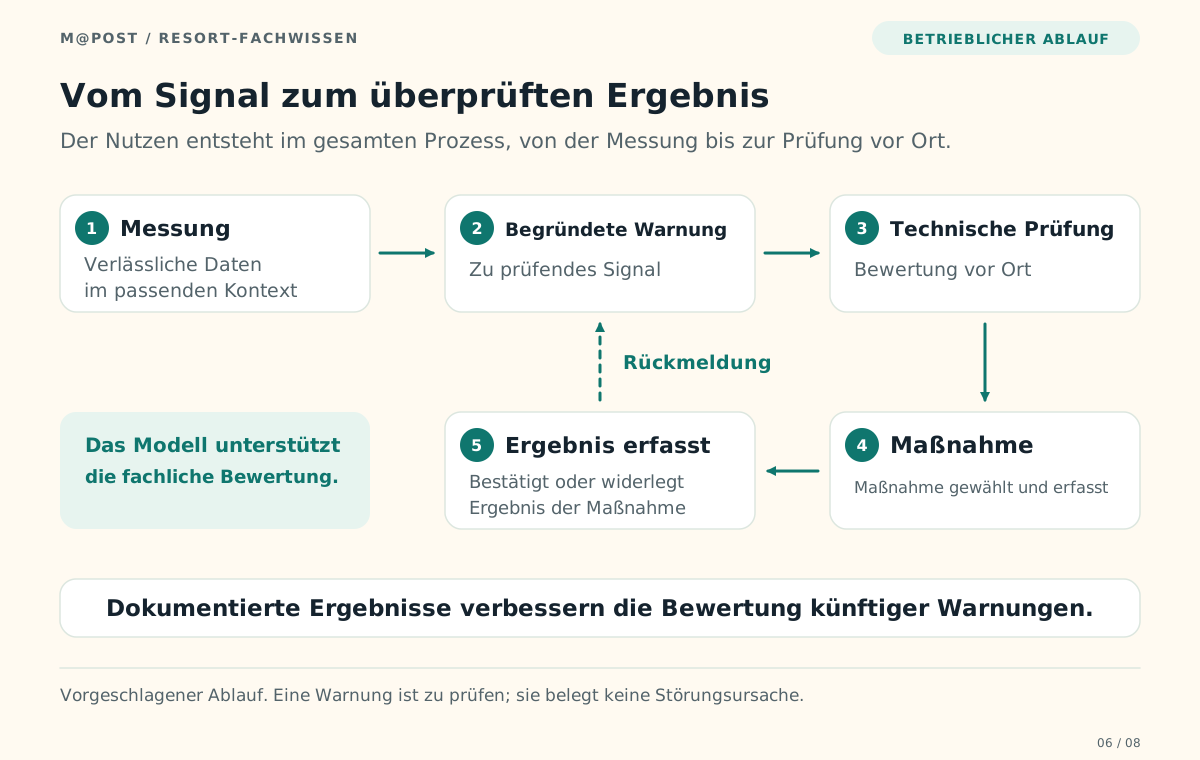
Textbeschreibung dieser Abbildung
Fünf Schritte verbinden Messung, Warnung, technische Prüfung, Maßnahme und Ergebnis; eine Rückkopplung unterstützt die Bewertung der Warnungen.
Das Signal mit der Wiederherstellung verbinden
Der nutzbringende Prozess ist vollständig, wenn aus einer Warnung eine Entscheidung, eine Maßnahme und ein überprüftes Ergebnis werden. Das Überwachungssystem beschreibt das Anlagenverhalten; der Instandhaltungsprozess weist Arbeit, Termine und Verantwortlichkeiten zu. Das CMMS kann als betriebliche Dokumentation dienen, abhängig von den tatsächlich verfügbaren Funktionen und Anbindungen.
Für M@Post ist deshalb ein schrittweises Vorgehen entscheidend: mit verlässlichen Daten beginnen, ein eng umrissenes Problem wählen, Warnungen prüfen und die wiederhergestellte Leistung messen. Reife zeigt sich, wenn das Team versteht, warum es eingreift, und das Ergebnis nachweisen kann. Eine Vorhersage hat dann einen Wert, wenn sie rechtzeitig kommt, um eine Entscheidung zu verändern.
Quellen und Verweise
- Lawrence Berkeley National Laboratory — Proving the Business Case for Building AnalyticsVeröffentlicht: 2020-10. Quellen geprüft am 21. November 2026.Datenzeitraum und Geltungsbereich: Smart Energy Analytics Campaign 2016–2020
So wird diese Quelle verwendet
104 Organisationen und 6.500 Gebäude; jährliche Energieeinsparungen im Median von 3 % für EIS und 9 % für FDD.
Zahlen im offiziellen Abstract geprüft. Programm für gewerblich genutzte Gebäude; keine garantierte Übertragbarkeit auf Resorts oder ein CMMS.
- US Department of Energy — Federal Energy Management Program — Energy Management Information System CapabilitiesQuellen geprüft am 21. November 2026.Datenzeitraum und Geltungsbereich: Aktuelle technische Ressource, abgerufen am 21. November 2026
So wird diese Quelle verwendet
Automatisierte Diagnose einschließlich regelbasierter Verfahren; zustandsorientierte oder vorausschauende Empfehlungen und Verbindung zum Instandhaltungsprozess.
Abschnitte Automated Fault Detection and Diagnostics und Operations and Maintenance Optimization. Die Unterscheidungen in der Tabelle sind eine redaktionelle betriebliche Zusammenfassung.
- National Institute of Standards and Technology — Artificial Intelligence Risk Management Framework (AI RMF 1.0)Veröffentlicht: 2023-01. Quellen geprüft am 21. November 2026.Datenzeitraum und Geltungsbereich: Methodischer Rahmen, Version 1.0
So wird diese Quelle verwendet
Freiwilliger Rahmen für KI-Risikomanagement, Validität, Zuverlässigkeit, Transparenz und Rollensteuerung über den Lebenszyklus.
Offizielles Dokument NIST AI 100-1. Die NIST-Website weist auf eine laufende Überarbeitung hin; der Artikel nennt ausdrücklich Version 1.0.