Del mantenimiento reactivo al predictivo: cuándo ayudan los datos y la IA
Cómo elegir un primer proyecto de mantenimiento basado en la condición o predictivo para un resort, distinguir supervisión, diagnóstico e IA y medir el valor de las alertas.
En esta guía
- El problema viene antes que el algoritmo
- Evidencias reales del valor del análisis de edificios
- Distinguir cuatro decisiones diferentes
- Elegir un primer caso de uso con un resultado observable
- Organizar los datos antes de entrenar un modelo
- Evaluar las alertas frente al trabajo real
- El papel de la IA y el de las personas
- Conectar la señal con el restablecimiento del servicio
El problema viene antes que el algoritmo
Una bomba se avería y el equipo responde: es mantenimiento reactivo. La misma bomba se inspecciona periódicamente: existe un enfoque preventivo organizado. Una medición identifica un deterioro y permite programar una actuación: el trabajo vuelve a cambiar. Ninguno de estos pasos exige, por sí solo, afirmar que el sistema utiliza inteligencia artificial.
Para un resort, la primera pregunta debe referirse al servicio: ¿qué avería queremos identificar antes, qué señal podría anticiparla y cuánto tiempo necesitamos para actuar? Si un repuesto tarda semanas en llegar y la señal aparece solo horas antes de la avería, el análisis puede ser interesante sin resolver el problema operativo. Si nadie recibe y evalúa las alertas, incluso un modelo preciso quedará sin utilizar.
Evidencias reales del valor del análisis de edificios
La Smart Energy Analytics Campaign, desarrollada en Estados Unidos entre 2016 y 2020, incluyó 104 organizaciones y 6.500 edificios. El informe de Lawrence Berkeley National Laboratory registra ahorros energéticos anuales medianos del 3% para los Energy Information Systems y del 9% para la detección y el diagnóstico de fallos, o FDD.[1]
Son resultados de un programa que abarca edificios comerciales, no una demostración de que cualquier resort vaya a lograr los mismos porcentajes. Se refieren a herramientas y procesos de gestión energética: no equivalen a ahorros garantizados por un CMMS ni demuestran que la IA generativa pueda predecir una avería. Sí indican que organizar datos y utilizarlos para corregir el funcionamiento de las instalaciones puede producir resultados medibles.
Distinguir cuatro decisiones diferentes
| Enfoque | Qué desencadena la actuación | Ejemplo en un resort |
|---|---|---|
| Correctivo | Una avería o defecto ya producido | Restablecer un ventilador que se ha detenido |
| Preventivo programado | Un vencimiento, utilización o programa definido | Inspección planificada según las condiciones e instrucciones aplicables |
| Basado en la condición | Un estado medido e interpretado | Revisar un componente cuando un parámetro indica deterioro |
| Predictivo | Una estimación del comportamiento futuro | Programar un trabajo a partir de una previsión validada del deterioro |
La tabla establece una distinción operativa útil para elegir proyectos; algunos términos pueden solaparse en la documentación técnica. El US Department of Energy describe tanto diagnósticos automáticos basados en reglas como aplicaciones que utilizan datos de las instalaciones para producir recomendaciones de mantenimiento.[2] Una alarma por umbral no es, por sí sola, una predicción; un diagnóstico automático puede funcionar sin aprendizaje automático.
No todos los componentes necesitan el enfoque más sofisticado. Una estrategia sencilla puede ser razonable para un elemento económico, accesible y cuya avería no tenga consecuencias relevantes. En un servicio esencial, la combinación de inspecciones, redundancia, repuestos y experiencia puede importar más que la complejidad del modelo.
Elegir un primer caso de uso con un resultado observable
Un buen piloto empieza por una familia limitada de equipos y un fenómeno definido. Por ejemplo, puede buscarse un funcionamiento incoherente en un circuito de calefacción o refrigeración bajo condiciones operativas comparables. El proyecto necesita establecer qué parámetros hacen falta, qué comprobación sobre el terreno confirmará la anomalía y qué actuación puede realizarse.
La ficha del proyecto debe incluir problema, impacto sobre el servicio, señales disponibles, calidad mínima exigida, responsable de la evaluación y criterio de éxito. Conviene añadir también un criterio de parada: si las alertas no pueden verificarse o generan más trabajo innecesario que beneficio, el proyecto debe corregirse antes de ampliarlo.
El primer objetivo puede ser modesto y útil: identificar una anomalía recurrente antes de que la comunique un huésped. No hace falta prometer una fecha exacta de avería cuando los datos disponibles solo permiten reconocer un comportamiento inusual.
Organizar los datos antes de entrenar un modelo
El identificador del equipo debe mantenerse estable y ser reconocible en los sistemas implicados. Las marcas de tiempo, las unidades y los métodos de recogida deben ser coherentes. Un valor ausente no es cero; una medición reconstruida no equivale a una lectura; sustituir un sensor puede introducir una discontinuidad que el modelo interprete erróneamente como una avería.
El historial debe distinguir, como mínimo, el síntoma comunicado, la causa verificada, la actuación realizada y el resultado. Si todos los trabajos se cierran con «reparado», el sistema no dispone de suficiente información de retorno para aprender qué señales eran significativas. Los periodos sin averías también aportan información: hay que saber cuándo funcionó normalmente la instalación y en qué condiciones.
Antes de evaluar prestaciones avanzadas, se comprobará la integridad de los registros y la disponibilidad efectiva de los datos. Un proyecto que solo abarque la temporada baja no demuestra automáticamente cómo funcionará con ocupación completa. La calidad del modelo también depende de la representatividad de las condiciones observadas.
Evaluar las alertas frente al trabajo real
Ejemplo ilustrativo — hipótesis, no datos observados. Durante un periodo piloto se generan 20 alertas de sucesos distintos. Los técnicos confirman 12 como anomalías pertinentes; 8 son falsas alarmas. La proporción confirmada de las alertas generadas es, por tanto, 12/20 = 60%. Este indicador no muestra cuántos problemas dejó sin detectar el sistema.
Medir las detecciones omitidas requiere una verificación independiente. Si durante el periodo se hubieran confirmado 15 anomalías del tipo buscado y se hubieran detectado 12, la proporción reconocida sería 12/15 = 80%. Las dos medidas responden a preguntas distintas: cuánta confianza merece una alerta y cuántos sucesos puede reconocer el sistema.
La evaluación también debe considerar la anticipación útil, las horas dedicadas a comprobaciones innecesarias y la viabilidad de actuar. Una predicción debe probarse con datos de un periodo posterior al utilizado para construirla, evitando evaluarla con información que el modelo ya ha visto. La verificación debe repetirse cuando cambien la instalación o su régimen operativo.
El papel de la IA y el de las personas
La IA puede ayudar a organizar avisos, identificar patrones recurrentes o preparar un resumen del historial. Cuando ofrece una explicación técnica, esta debe poder contrastarse con registros, mediciones y documentos pertinentes. Una respuesta plausible no es una evidencia de la causa de una avería.
El NIST AI Risk Management Framework 1.0, publicado en 2023, ofrece un marco voluntario para gestionar riesgos durante la vida de los sistemas de IA, con atención a validez, fiabilidad, transparencia y supervisión.[3] En un resort, este enfoque se traduce en reglas prácticas: identificar quién evalúa una alerta, registrar por qué se acepta o descarta y conservar un procedimiento utilizable cuando el análisis automático no esté disponible.
En una plataforma utilizada por distintas organizaciones, la separación de datos debe abarcar todo el proceso: acceso, documentos recuperados, tratamiento y resultados. Los datos de un resort no deben aparecer en respuestas destinadas a otro. Son requisitos que deben verificarse en la arquitectura y en el funcionamiento del servicio, no capacidades atribuibles a un producto simplemente por describirlo como «inteligente».
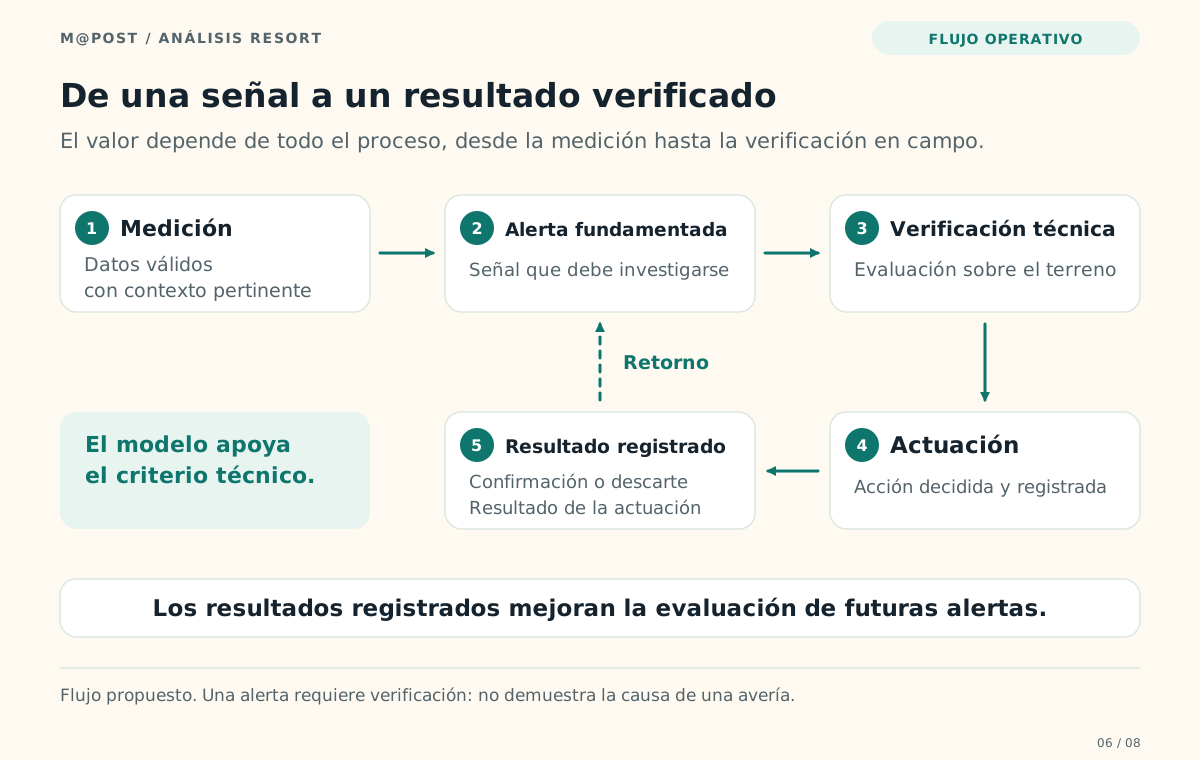
Descripción textual de la figura
Cinco pasos conectan medición, alerta, verificación técnica, actuación y resultado; un bucle de información de retorno orienta la evaluación de las alertas.
Conectar la señal con el restablecimiento del servicio
El proceso útil se completa cuando una alerta se convierte en una decisión, una actuación y un resultado verificado. La supervisión describe el comportamiento del equipo; el proceso de mantenimiento asigna trabajos, plazos y responsabilidades. El CMMS puede servir de registro operativo, según las integraciones y funciones realmente disponibles.
Para M@Post, el enfoque que debe quedar claro es gradual: partir de datos fiables, elegir un problema bien delimitado, verificar las alertas y medir el servicio restablecido. La madurez se aprecia cuando el equipo comprende por qué interviene y puede demostrar el resultado. Una predicción tiene valor cuando llega a tiempo de cambiar una decisión.
Fuentes y referencias
- Lawrence Berkeley National Laboratory — Proving the Business Case for Building AnalyticsPublicado: 2020-10. Fuentes consultadas el 21 de noviembre de 2026.Periodo y ámbito de los datos: Smart Energy Analytics Campaign 2016–2020
Cómo se utiliza esta fuente
104 organizaciones y 6.500 edificios; ahorros energéticos anuales medianos del 3% para EIS y del 9% para FDD.
Cifras verificadas en el resumen oficial. Campaña de edificios comerciales; no se garantiza su extrapolación a resorts ni a un CMMS.
- US Department of Energy — Federal Energy Management Program — Energy Management Information System CapabilitiesFuentes consultadas el 21 de noviembre de 2026.Periodo y ámbito de los datos: Recurso técnico vigente consultado el 21 de noviembre de 2026
Cómo se utiliza esta fuente
Diagnóstico automático, incluidos métodos basados en reglas; recomendaciones por condición o predictivas y conexión con el proceso de mantenimiento.
Apartados Automated Fault Detection and Diagnostics y Operations and Maintenance Optimization. Las distinciones de la tabla son una síntesis operativa editorial.
- National Institute of Standards and Technology — Artificial Intelligence Risk Management Framework (AI RMF 1.0)Publicado: 2023-01. Fuentes consultadas el 21 de noviembre de 2026.Periodo y ámbito de los datos: Marco metodológico, versión 1.0
Cómo se utiliza esta fuente
Marco voluntario para gestionar riesgos de IA, validez, fiabilidad, transparencia y funciones a lo largo del ciclo de vida.
Documento oficial NIST AI 100-1. La web del NIST indica que hay una revisión en curso; el artículo identifica expresamente la versión 1.0.