De la maintenance réactive à la maintenance prédictive : quand les données et l’IA sont utiles
Choisir un premier projet de maintenance conditionnelle ou prédictive pour un resort, distinguer surveillance, diagnostic et IA, puis mesurer l’utilité des alertes.
Dans ce guide
- Le problème précède l’algorithme
- Des résultats réels sur l’intérêt de l’analyse des bâtiments
- Distinguer quatre décisions différentes
- Choisir un premier cas d’usage au résultat observable
- Organiser les données avant d’entraîner un modèle
- Évaluer les alertes au regard du travail réel
- Le rôle de l’IA et celui des personnes
- Relier le signal au rétablissement du service
Le problème précède l’algorithme
Une pompe tombe en panne et l’équipe intervient : c’est de la maintenance réactive. La même pompe est inspectée périodiquement : une démarche préventive est organisée. Une mesure identifie une dégradation et permet de programmer une intervention : le travail change encore. Aucune de ces étapes ne nécessite, à elle seule, d’affirmer que le système utilise l’intelligence artificielle.
Pour un resort, la première question doit concerner le service : quelle défaillance voulons-nous repérer plus tôt, quel signal peut l’annoncer et de combien de temps avons-nous besoin pour agir ? Si une pièce met plusieurs semaines à arriver et que le signal apparaît seulement quelques heures avant la panne, l’analyse peut être intéressante sans résoudre le problème opérationnel. Si personne ne reçoit et n’évalue les alertes, même un modèle précis restera inutilisé.
Des résultats réels sur l’intérêt de l’analyse des bâtiments
La Smart Energy Analytics Campaign, menée aux États-Unis entre 2016 et 2020, a réuni 104 organisations et 6 500 bâtiments. Le rapport du Lawrence Berkeley National Laboratory indique des économies annuelles médianes d’énergie de 3 % pour les systèmes d’information énergétique, ou EIS, et de 9 % pour la détection et le diagnostic des défauts, ou FDD.[1]
Ces résultats concernent un programme portant sur des bâtiments commerciaux ; ils ne prouvent pas que tout resort obtiendra les mêmes pourcentages. Ils portent sur des outils et processus de gestion énergétique : ils ne constituent ni des économies garanties par une GMAO, ni la démonstration qu’une IA générative peut prévoir une panne. Ils indiquent cependant que l’organisation des données et leur utilisation pour corriger le fonctionnement des installations peuvent produire des résultats mesurables.
Distinguer quatre décisions différentes
| Approche | Déclencheur de l’intervention | Exemple dans un resort |
|---|---|---|
| Corrective | Une panne ou un défaut déjà survenu | Rétablir un ventilateur arrêté |
| Préventive planifiée | Une échéance, un usage ou un programme défini | Inspection programmée selon les conditions et consignes applicables |
| Conditionnelle | Un état mesuré et interprété | Vérifier un composant lorsqu’un paramètre révèle une dégradation |
| Prédictive | Une estimation du comportement futur | Programmer le travail à partir d’une prévision validée de dégradation |
Ce tableau propose une distinction opérationnelle utile au choix des projets ; certains termes peuvent se recouper dans la documentation technique. Le Department of Energy américain décrit à la fois des diagnostics automatisés fondés sur des règles et des applications qui exploitent les données des systèmes pour formuler des recommandations de maintenance.[2] Une alarme de seuil n’est pas, à elle seule, une prévision ; un diagnostic automatisé peut fonctionner sans apprentissage automatique.
Tous les composants n’exigent pas l’approche la plus sophistiquée. Une stratégie simple peut être raisonnable pour un élément peu coûteux, accessible et dont la défaillance n’a pas de conséquence significative. Pour un service essentiel, l’association d’inspections, de redondance, de pièces et de compétences peut compter davantage que la complexité du modèle.
Choisir un premier cas d’usage au résultat observable
Un bon projet pilote commence avec une famille limitée d’équipements et un phénomène défini. Il peut, par exemple, viser à repérer un fonctionnement incohérent dans un circuit de chauffage ou de refroidissement, à conditions d’exploitation comparables. Le projet doit déterminer les paramètres nécessaires, le contrôle sur place qui confirmera l’anomalie et l’action possible.
La fiche du projet doit préciser le problème, ses conséquences sur le service, les signaux disponibles, la qualité minimale requise, le responsable de l’évaluation et le critère de réussite. Il est également utile d’ajouter un critère d’arrêt : si les alertes ne peuvent pas être vérifiées ou créent davantage de travail inutile que de bénéfices, le projet doit être corrigé avant son extension.
Le premier objectif peut être modeste et utile : repérer une anomalie récurrente avant son signalement par un client. Il n’est pas nécessaire de promettre une date de panne exacte lorsque les données permettent seulement de reconnaître un comportement inhabituel.
Organiser les données avant d’entraîner un modèle
L’identifiant de l’équipement doit rester stable et être reconnaissable dans tous les systèmes concernés. Horodatages, unités et méthodes de collecte doivent être cohérents. Une valeur manquante n’est pas un zéro ; une mesure reconstituée n’équivaut pas à un relevé ; le remplacement d’un capteur peut introduire une discontinuité que le modèle interprète à tort comme une défaillance.
L’historique de maintenance doit au minimum distinguer symptôme signalé, cause vérifiée, action menée et résultat. Si chaque intervention est clôturée par « réparé », le système ne dispose pas d’un retour suffisant pour apprendre quels signaux étaient pertinents. Les périodes sans panne apportent elles aussi une information : il faut savoir quand l’installation a fonctionné normalement et dans quelles conditions.
Avant d’évaluer des performances avancées, vérifier l’exhaustivité des enregistrements et la disponibilité réelle des données. Un projet limité à la basse saison ne démontre pas automatiquement son efficacité les jours de pleine occupation. La qualité du modèle dépend aussi de la représentativité des situations observées.
Évaluer les alertes au regard du travail réel
Exemple illustratif — hypothèses, et non données observées. Pendant un pilote, 20 alertes sont générées pour des événements distincts. Les techniciens en confirment 12 comme des anomalies pertinentes ; 8 sont de fausses alertes. La proportion confirmée parmi les alertes émises est donc de 12/20 = 60 %. Cet indicateur ne dit pas combien de problèmes le système a manqués.
Mesurer les détections manquées exige également une vérification indépendante. Si 15 anomalies du type recherché avaient été confirmées au total pendant la période et que 12 avaient été détectées, la proportion reconnue serait de 12/15 = 80 %. Ces deux mesures répondent à des questions différentes : quelle confiance accorder à une alerte et combien d’événements le système sait reconnaître.
L’évaluation doit également considérer le délai d’anticipation utile, les heures consacrées aux vérifications inutiles et la possibilité concrète d’intervenir. Une prévision doit être testée sur des données d’une période postérieure à celles qui ont servi à construire le modèle, pour éviter de l’évaluer sur des informations déjà vues. La vérification doit être renouvelée après une modification de l’installation ou de son mode d’exploitation.
Le rôle de l’IA et celui des personnes
L’IA peut aider à organiser les signalements, à repérer des récurrences ou à préparer une synthèse de l’historique. Lorsqu’elle propose une explication technique, celle-ci doit pouvoir être vérifiée à partir des enregistrements, mesures et documents pertinents. Une réponse plausible ne prouve pas la cause d’une panne.
Le NIST AI Risk Management Framework 1.0, publié en 2023, propose un cadre volontaire de gestion des risques tout au long de la vie des systèmes d’IA, avec une attention portée à la validité, à la fiabilité, à la transparence et à la supervision.[3] Dans un resort, cette démarche se traduit par des règles concrètes : identifier qui évalue l’alerte, enregistrer pourquoi elle est retenue ou écartée et conserver une procédure utilisable lorsque l’analyse automatisée est indisponible.
Sur une plateforme utilisée par plusieurs organisations, la séparation des données doit couvrir l’ensemble du processus : accès, documents consultés, traitements et résultats. Les données d’un resort ne doivent pas apparaître dans les réponses destinées à un autre. Ce sont des exigences à vérifier dans l’architecture et le fonctionnement du service, et non des capacités à attribuer à un produit parce qu’il est qualifié d’« intelligent ».
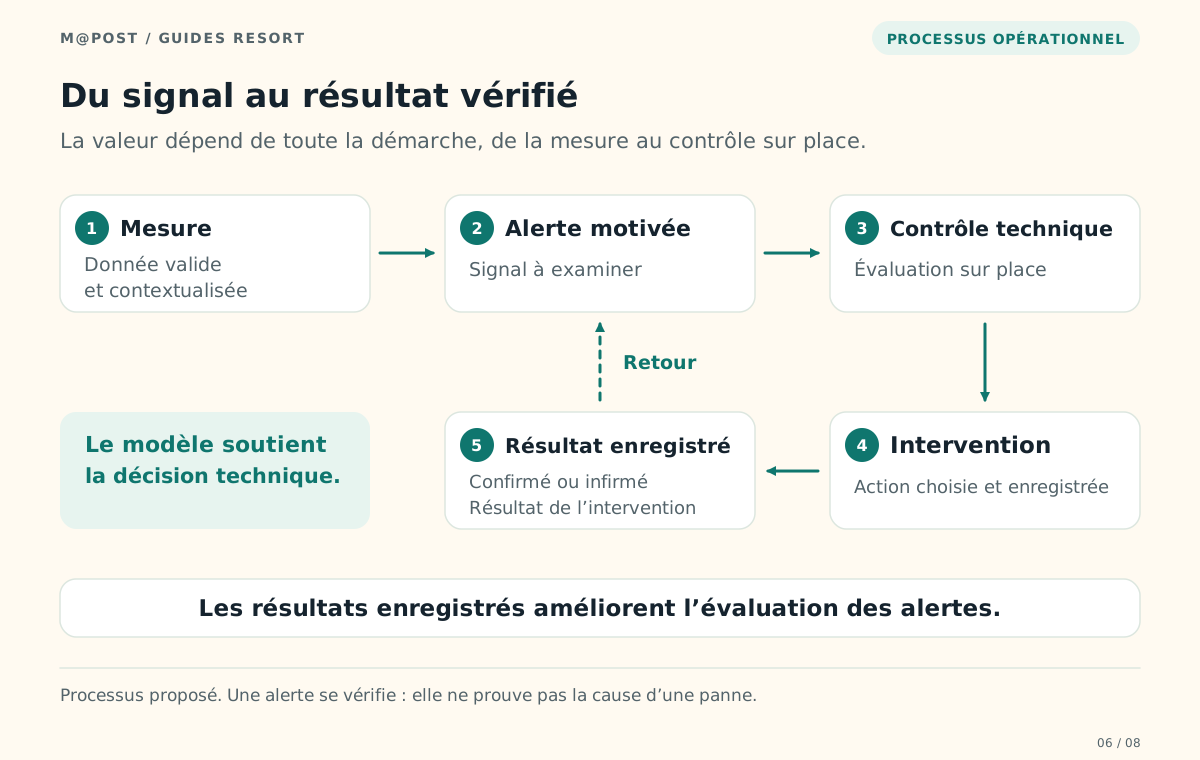
Description textuelle de cette figure
Cinq étapes relient mesure, alerte, vérification technique, intervention et résultat ; une boucle de retour alimente l’évaluation des alertes.
Relier le signal au rétablissement du service
Le processus utile est complet lorsqu’une alerte devient une décision, une intervention et un résultat vérifié. La surveillance décrit le comportement de l’équipement ; le processus de maintenance attribue travail, délais et responsabilités. La GMAO peut servir de registre opérationnel, selon les intégrations et fonctions réellement disponibles.
Pour M@Post, la démarche à rendre explicite est progressive : partir de données fiables, choisir un problème bien délimité, vérifier les alertes et mesurer le service rétabli. La maturité apparaît lorsque l’équipe comprend pourquoi elle intervient et peut démontrer le résultat. Une prévision a de la valeur lorsqu’elle arrive à temps pour modifier une décision.
Sources et références
- Lawrence Berkeley National Laboratory — Proving the Business Case for Building AnalyticsPublication: 2020-10. Sources vérifiées le 21 novembre 2026.Période et périmètre des données: Smart Energy Analytics Campaign 2016–2020
Utilisation de cette source
104 organisations et 6 500 bâtiments ; économies annuelles médianes d’énergie de 3 % pour les EIS et de 9 % pour les FDD.
Chiffres vérifiés dans le résumé officiel. Programme portant sur des bâtiments commerciaux ; aucune extrapolation garantie aux resorts ou à une GMAO.
- US Department of Energy — Federal Energy Management Program — Energy Management Information System CapabilitiesSources vérifiées le 21 novembre 2026.Période et périmètre des données: Ressource technique actuelle consultée le 21 novembre 2026
Utilisation de cette source
Diagnostic automatisé, y compris par règles ; recommandations conditionnelles ou prédictives et liaison avec le processus de maintenance.
Sections Automated Fault Detection and Diagnostics et Operations and Maintenance Optimization. Les distinctions du tableau sont une synthèse opérationnelle éditoriale.
- National Institute of Standards and Technology — Artificial Intelligence Risk Management Framework (AI RMF 1.0)Publication: 2023-01. Sources vérifiées le 21 novembre 2026.Période et périmètre des données: Cadre méthodologique, version 1.0
Utilisation de cette source
Cadre volontaire de gestion des risques de l’IA, validité, fiabilité, transparence et gestion des rôles tout au long du cycle de vie.
Document officiel NIST AI 100-1. Le site du NIST indique qu’une révision est en cours ; l’article identifie explicitement la version 1.0.